 Digercules
Digercules — это программа с нейросетевыми компонентами, которая берёт любую исходную неразобранную свалку файлов — архив, библиотеку, концертные записи, переписки в мессенджерах — и превращает её в структурированную библиотеку, включая умную дедупликацию: найти все копии одного и того же, убрать лишнее и при этом ничего важного не потерять. По каждому файлу — тема, язык, тип документа, ключевые сущности, краткое содержание. Это делается заранее, без спешки и дедлайна, пока никому это ещё не понадобилось срочно — а не в последний момент под конкретную задачу. Готовую библиотеку можно скормить любой нейросети, базе данных или поисковой системе — дальше они сами находят нужное и строят интерфейс; Digercules не заменяет этот следующий шаг, а делает его вообще возможным, беря на себя ту трудоёмкую подготовку, на которую обычно никогда не хватает ресурсов.
Данные обрабатываются без корпоративных облаков — либо на компьютере клиента целиком (при наличии необходимых мощностей видеокарты), либо автору программы передаются не исходники, а сжатые копии, подготовленные специально для распознавания, и обратно приходят только тексты.
Уже проверено на архивах разного масштаба — по реальной статистике обработанных проектов:
По имеющимся каналам связи (~30 Мбит/с, реальный замер) закачка этого объёма в облако заняла бы около 262 суток — против 96, за которые всё обработано на месте. Хранение обошлось бы от $84 в месяц, а обработка на сопоставимом по мощности GPU потребовала бы от $150–190 в месяц. И это без учёта ещё одного шага: данные из хранилища всё равно нужно перегнать на саму GPU-машину для обработки. Даже по каналу втрое быстрее (100 Мбит/с) партия в несколько терабайт идёт около 3 суток.
Что реально работает внутри
Digercules — не одна модель, а оркестрованный конвейер из 25+ фаз обработки: каждая решает одну узкую задачу, и результат одной становится входом для следующей.
Речь в текст. Аудио и видео проходят через faster-whisper (large-v3-turbo): сначала быстрый черновой проход — для сверки и отбора, затем медленный и тщательный основной проход с направляющими подсказками, построенными на собственной лексике архива. Если в архиве есть свой устойчивый круг голосов или своя специфическая терминология, модель можно дообучить (LoRA) именно на этом материале — проверено на сотнях часов одной конкретной коллекции.
Идентификация голоса. Модель голосовых эмбеддингов (ECAPA-TDNN) строит галерею голосов: кто говорит, сверяясь со всеми, кого система уже слышала раньше, — галерея растёт с каждым новым обработанным архивом.
Идентификация лиц. Та же логика, что и для голоса, но для лиц: галерея с несколькими эталонными образцами на человека — она умеет то, чего не может один усреднённый портрет, — узнавать одного и того же человека и в детстве, и сорок лет спустя. Экран подтверждения проверен на реальных 20 ТБ концертных видеозаписей.
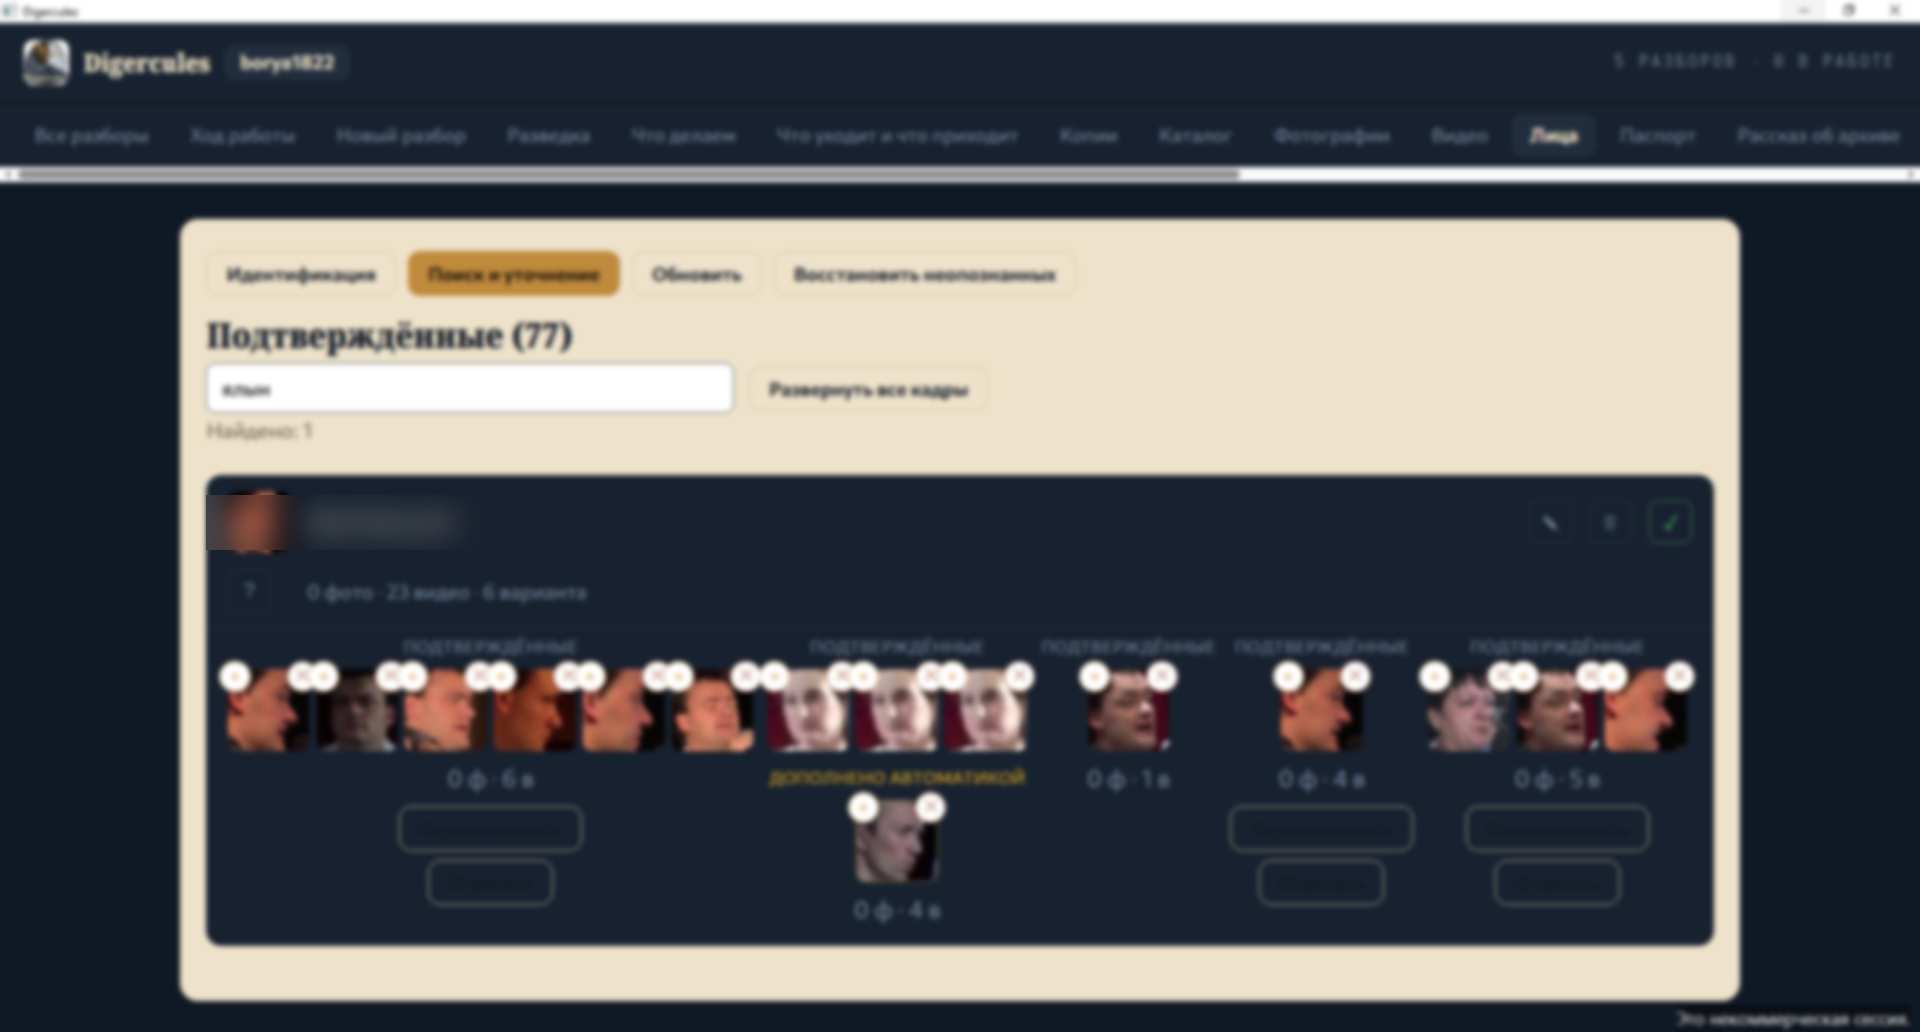
Решение всегда принимает человек: похожесть — это подсказка с процентом, а не готовый ответ, и безопасного порога, после которого её можно доверять автоматически, не существует — в интерфейсе это не скрывается. Лицо, которое никто не узнал, не выдаётся за опознанное, а ждёт того, кто архив знает лучше. Подробнее о принципах работы модуля.
Распознавание текста (OCR). Отсканированные документы проходят через Marker — открытый движок распознавания и конвертации PDF/сканов — и превращаются в текст, по которому можно искать, а не остаются картинкой с буквами.
Понимание фотографий — по уровням. Каждый фотобанк сначала проходит дешёвый проход на CPU (OpenCV DNN — EAST ищет текстовые области, YuNet считает лица), который работает одинаково на любой машине флота, включая десятилетний Windows 7. На более мощном железе добавляется второй проход — CLIP zero-shot классификация сцены на скорости GPU. Там, где это действительно важно, полноценная визуально-языковая модель (Ollama) пишет настоящее описание конкретного фото. Три уровня, от дешёвого к дорогому.
Понимание документов. Каждый файл читается и описывается локальной языковой моделью (Ollama): о чём он, на каком языке, для чего на самом деле нужен.
Дедупликация, которая заодно защищает файлы. Тот же хэш, что находит дублирующиеся копии, заодно побайтово подтверждает: файл, вернувшийся в архив после обработки, — тот же самый файл, что из него уходил.
Каждый из этих этапов выполняется либо локально, либо на конкретной, названной вам машине — никогда в безликом облаке.
Статус
Продукт в активной разработке. Инженерная библиотека — стабильно, в продакшне.
География команды
Разработка ведётся распределённой командой в нескольких странах: Израиль, Грузия, Россия. Реальные точки присутствия вычислительной инфраструктуры: Ришон-ле-Цион, Израиль · Тбилиси, Грузия · Челябинск, Россия · Москва, Россия.
Куда дальше
Digercules обслуживает разные типы заказчиков через отдельные сайты:
- digercules.ru — российские потребители, архив живых выступлений (бардовская песня и не только)
- digercules.org — предложения для организаций
- digercules.net — частные заказчики, конкретные юзкейсы
Как это оплачивается
Локальный самостоятельный прогон — разовая покупка программы без ограничения по объёму архива; бесплатна только предварительная оценка по описанию или скриншоту архива. Более тяжёлая координация, когда своей мощности не хватает, — отдельно, по цене, которая формируется по факту обнаруженного объёма работы: конкретных цифр здесь пока нет. Ориентир по рынку — цифры выше на этой странице (во сколько обошлась бы сопоставимая задача через обычное облако). Подробности по сценариям — на digercules.org и digercules.net.